


Todos los viernes, miles de personas revisan las tablas de frecuencia de su lotería favorita buscando el número que "ya se demoró demasiado" en salir. La creencia es tan vieja como el juego mismo: si una bola no ha aparecido en muchos sorteos, su turno está por llegar; si otra ha salido varias veces seguidas, está "en racha" y conviene apostarle. Pero, ¿realmente el balotaje recuerda lo que pasó la semana pasada?
Resumen clave
Cada sorteo de lotería es un evento estadísticamente independiente, lo que significa que los números fríos y calientes no tienen capacidad predictiva real. Su existencia se debe a la variación aleatoria normal, no a un sesgo del mecanismo de sorteo.
Qué son los números fríos y calientes, en términos reales
En el análisis de frecuencia de lotería, un número "caliente" es simplemente aquel que ha salido más veces de lo esperado dentro de una ventana de sorteos determinada (por ejemplo, los últimos 50 o 100 sorteos). Un número "frío" es el que ha salido menos de lo esperado en esa misma ventana.
Son etiquetas puramente descriptivas de datos pasados, no categorías predictivas. Así lo explica un análisis educativo sobre el tema: un número clasificado como "caliente" tras 50 sorteos no tiene mayor probabilidad de salir en el sorteo 51, y uno "frío" tampoco tiene menor probabilidad, porque, como resume el sitio especializado Lottery Valley, la máquina de sorteo "no sabe ni le importa lo que pasó antes".
Esta confusión tiene nombre en psicología cognitiva: la falacia del jugador (gambler's fallacy). Es la creencia de que la probabilidad de un evento disminuye porque acaba de ocurrir, aun cuando el proceso es objetivamente independiente de un sorteo a otro. Un estudio publicado en Management Science que analizó el juego de números diario de Maryland documentó exactamente este patrón de comportamiento: el dinero apostado a un número caído sharply inmediatamente después de que sale, y se recupera gradualmente durante varios meses, aunque la probabilidad real nunca cambió (Management Science / INFORMS).
La independencia estadística, explicada sin jerga
Pensemos en una moneda. Si sale cara cinco veces seguidas, mucha gente asume que "toca" que salga cruz. Sin embargo, la probabilidad de la sexta tirada sigue siendo 50/50, exactamente igual que en la primera. El sitio de divulgación matemática The Math Doctors lo plantea con una analogía útil: en cada sorteo, es como si se repartieran boletos completamente nuevos: la probabilidad de cualquier combinación en el sorteo de hoy no tiene absolutamente ningún efecto sobre la probabilidad de esa misma combinación —o de cualquier otra— en el sorteo de mañana (The Math Doctors).
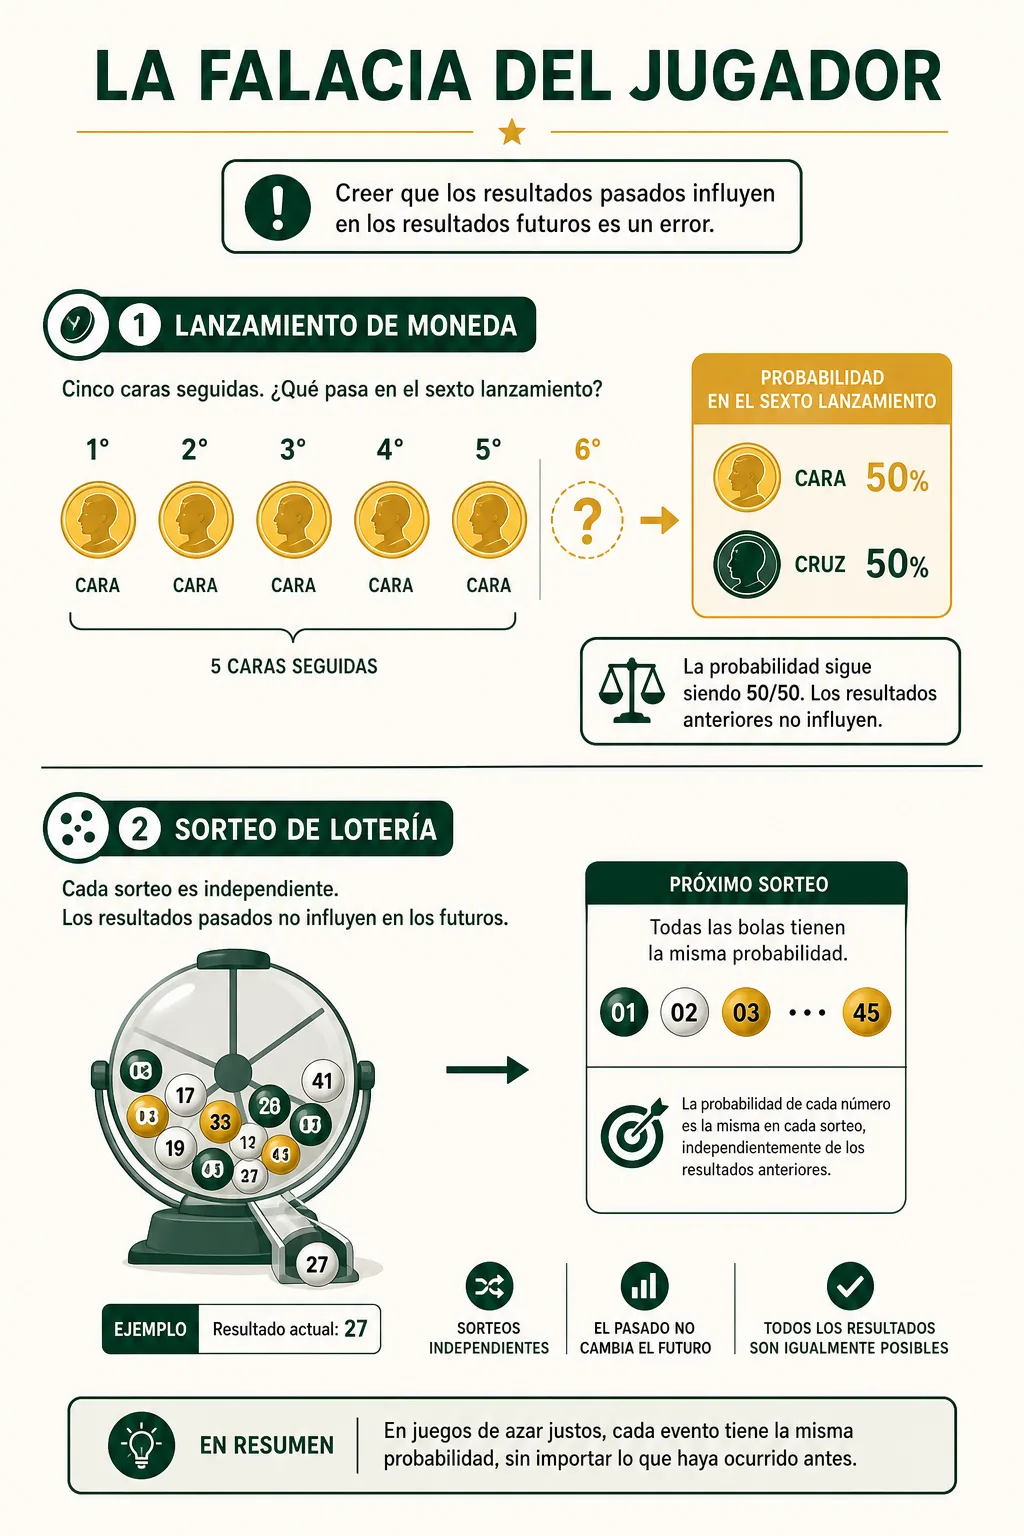
La falacia del jugador: la creencia errónea de que eventos pasados influyen en la probabilidad de resultados futuros en juegos de azar, como la lotería o el lanzamiento de una moneda.
Esto aplica igual a las bolas de lotería, a los dados y a la ruleta, siempre que el mecanismo de generación sea verdaderamente aleatorio. La revista Skeptical Inquirer resume el error de fondo: fallamos en reconocer que eventos independientes son, precisamente, independientes; ni la moneda ni el bombo de lotería recuerdan la secuencia de resultados anteriores (Skeptical Inquirer).
Por qué nuestro cerebro insiste en ver patrones
El motivo por el que los humanos caemos en esta trampa una y otra vez tiene una explicación bien documentada: esperamos que incluso muestras pequeñas de eventos aleatorios "representen" fielmente la probabilidad general. Si sabemos que una moneda es justa (50/50), asumimos —erróneamente— que una serie corta de tiradas también debería reflejar ese equilibrio. Es lo que Kahneman y Tversky bautizaron como el "error de representatividad", y explica por qué una secuencia como cara-cruz-cara-cruz-cara nos parece "más aleatoria" que cara-cara-cara-cara-cruz, cuando en realidad ambas son igual de probables.
La evidencia empírica: cinco años de datos no mienten
Aquí es donde la teoría se convierte en periodismo de datos. Durante los últimos años, investigadores han sometido los sorteos reales de lotería —no simulaciones— a pruebas estadísticas rigurosas para verificar si el hardware de sorteo (bombos, máquinas neumáticas, generadores de números aleatorios) introduce algún sesgo mecánico.
El método estándar para esta verificación es la prueba de chi-cuadrado de bondad de ajuste, que compara las frecuencias observadas de cada número contra la frecuencia matemáticamente esperada si el proceso fuera perfectamente aleatorio. A esto se suman la prueba de rachas (runs test), que detecta patrones secuenciales, y la prueba de correlación serial, que busca dependencias entre sorteos consecutivos.
Un estudio académico publicado en la revista Journal of Statistical Applications aplicó exactamente esta batería de pruebas a los datos históricos de dos loterías institucionales: la lotería Melate de México y loterías italianas. Los investigadores usaron los registros oficiales publicados por Pronósticos Deportivos para la Asistencia Pública (pronosticos.gob.mx) desde 1984 —cuando el juego seleccionaba 6 números de un total de 39— hasta las reglas actuales, y no encontraron evidencia estadísticamente significativa de que el mecanismo de sorteo se desviara de la aleatoriedad esperada (ScienceDirect).
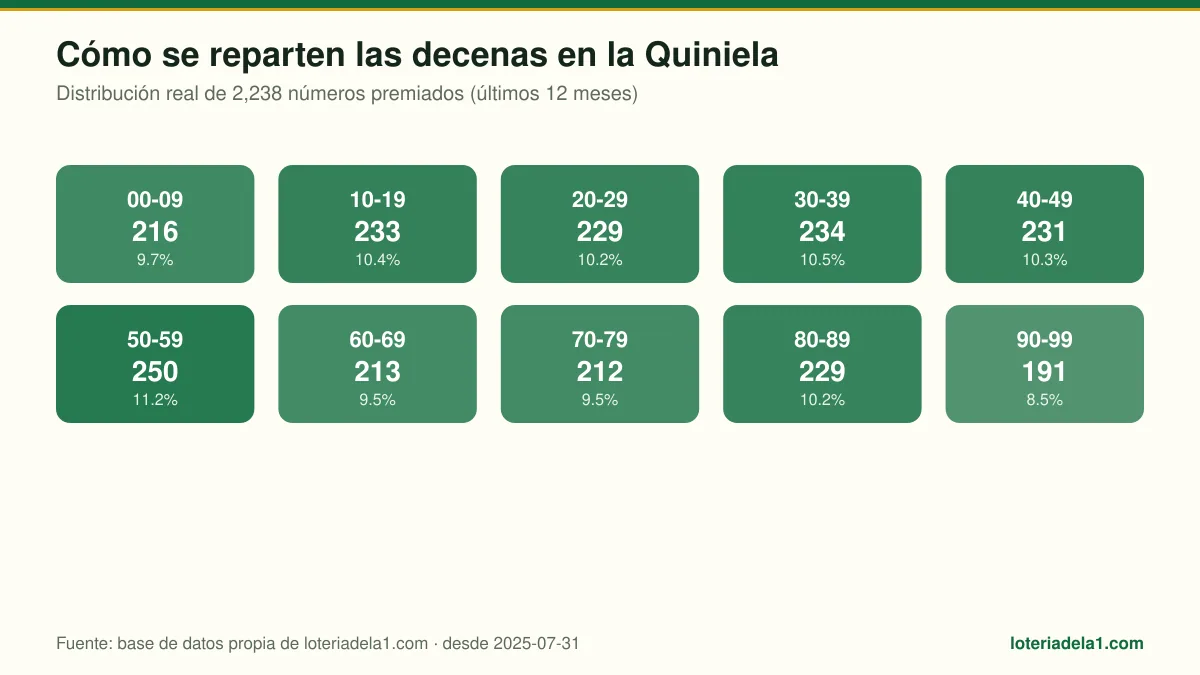
Distribución real de las decenas en los resultados de la Quiniela dominicana, ilustrando cómo la frecuencia de los números se mantiene dentro de los parámetros esperados de aleatoriedad a lo largo del tiempo. (Datos propios de loteriadela1.com)
Esta metodología no es exclusiva del mundo académico: los organismos reguladores de lotería alrededor del mundo exigen auditorías equivalentes. Según describe un análisis técnico sobre integridad de sorteos, laboratorios certificadores independientes —como GLI, BMM Testlabs e iTech Labs— someten tanto los bombos mecánicos como los generadores electrónicos de números aleatorios a pruebas de chi-cuadrado, correlación serial y desviación de entropía, exigiendo que los resultados se mantengan dentro de intervalos de confianza del 99% (tothenew.com).
Tabla: qué mide cada prueba de aleatoriedad
Chi-cuadrado de bondad de ajuste
Prueba de rachas (runs test)
Correlación serial
Análisis de gaps (Haigh, 1997)
| Prueba estadística | Qué verifica | Qué detectaría si fallara |
|---|---|---|
| Chi-cuadrado de bondad de ajuste | Si cada número aparece con la frecuencia matemáticamente esperada | Bolas con peso o tamaño distinto, desgaste desigual del mecanismo |
| Prueba de rachas (runs test) | Si la secuencia de resultados muestra patrones no aleatorios | Fallas de mezcla en el bombo, agrupamientos anómalos |
| Correlación serial | Si un sorteo influye estadísticamente en el siguiente | Defectos mecánicos que "recuerden" resultados anteriores |
| Análisis de gaps (Haigh, 1997) | Cuántos sorteos transcurren entre apariciones repetidas de un mismo número | Números que salen sistemáticamente más o menos seguido de lo esperado |
Un caso histórico ilustra por qué esta vigilancia importa: en el sorteo de reclutamiento de Estados Unidos de 1970, análisis de chi-cuadrado revelaron sesgos reales causados por una mezcla física deficiente de las cápsulas con fechas de nacimiento, no por ningún tipo de "memoria" del sistema, sino por un defecto de diseño en el mecanismo de mezcla. Ese episodio, documentado en registros de estadística aplicada, es precisamente el motivo por el que hoy las loterías modernas usan bombos con múltiples etapas de agitación y protocolos de auditoría estrictos.
Entonces, ¿por qué sí existen los números "calientes" en las tablas?
Aquí está la clave que un artículo de datos serio no puede omitir: los números calientes y fríos sí existen como fenómeno observable, pero son producto pura y exclusivamente de la variación estadística natural, no de un sesgo del mecanismo. Con 49 o 59 números posibles y cientos de sorteos acumulados, es matemáticamente inevitable que algunos números se agrupen por encima o por debajo del promedio, de la misma forma en que lanzar una moneda 100 veces casi nunca da exactamente 50 caras y 50 cruces.
Cuanto más corta es la ventana de sorteos analizada, mayor es esta variación aparente. Por eso, una tabla de frecuencia basada en solo 30 sorteos mostrará muchos más números "extremos" (muy calientes o muy fríos) que una tabla basada en 500 sorteos, donde las frecuencias tienden a converger hacia el promedio esperado —un efecto conocido como la ley de los grandes números.
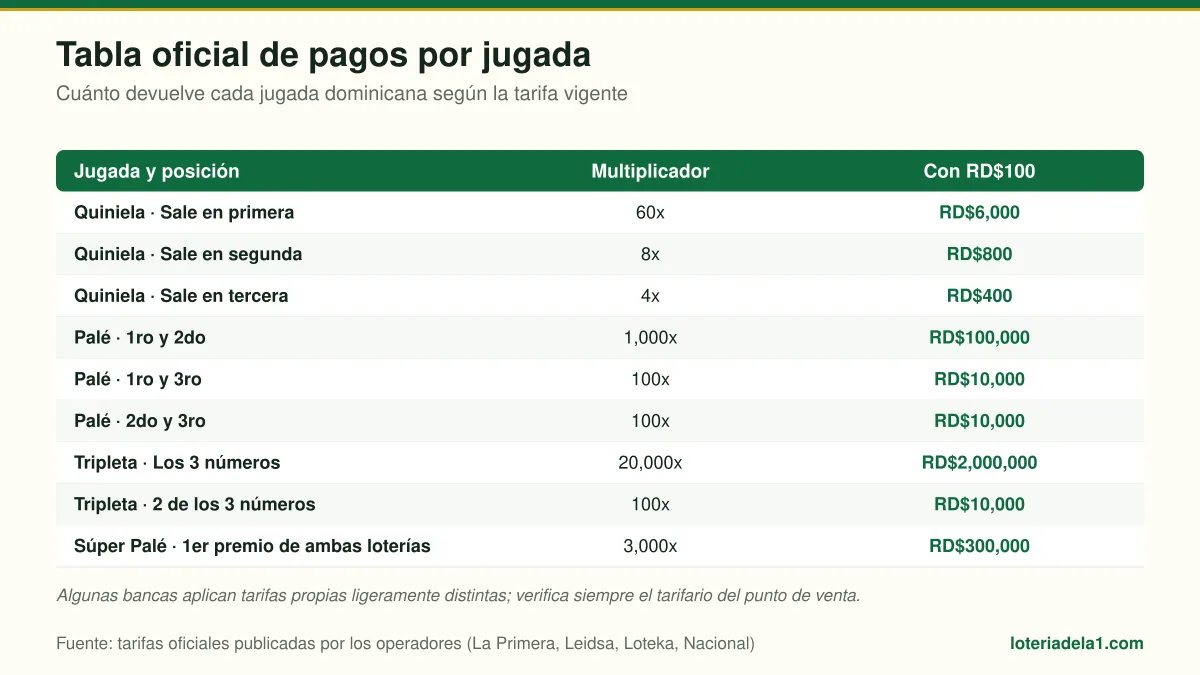
Comparativa de probabilidades del premio mayor en las principales loterías de Estados Unidos, destacando la dificultad inherente de acertar la combinación ganadora, independientemente de los números 'fríos' o 'calientes'. (Tabla de loteriadela1.com con tarifas oficiales)
El otro lado de la moneda: por qué la gente sigue apostando a lo "caliente"
Curiosamente, la investigación de comportamiento muestra que los jugadores no son consistentes en su error. Un estudio longitudinal publicado en la revista Judgment and Decision Making, que analizó cientos de millones de apuestas reales a lo largo de 118 sorteos semanales consecutivos, encontró que los jugadores tienden a evitar los números ganadores recientes justo después de que salen —la clásica falacia del jugador—, pero ese efecto se diluye con el tiempo, y el número se vuelve progresivamente más "atractivo" para apostar hasta que vuelve a salir, revelando también rastros del sesgo contrario, conocido como la "mano caliente" (Cambridge University Press / JDM).
Investigadores como Suetens et al. documentaron un patrón similar: los jugadores de lotería suelen evitar números recién sorteados (falacia del jugador), pero apuestan más a números que han salido varias veces seguidas en poco tiempo (efecto de "mano caliente"), demostrando que ambos sesgos cognitivos pueden coexistir dependiendo del diseño específico del juego (investigación citada en ResearchGate).
Ambos comportamientos —evitar lo reciente y perseguir lo "caliente"— parten del mismo error de fondo: asumir que el pasado del sorteo contiene información útil sobre el futuro, cuando en un sistema verdaderamente aleatorio esa información simplemente no existe.

